 Enver KOÇAK
Amazon Web Services, büyük dil modellerinin üretim ortamlarında daha verimli çalıştırılabilmesi amacıyla Amazon SageMaker HyperPod Inference altyapısına NVIDIA Dynamo entegrasyonunun eklendiğini duyurdu. Yapay zekâ altyapılarında model ağırlıklarının GPU belleğine sığdırılması ve özellikle uzun girdi istemlerinin işlenmesi sırasında yaşanan performans darboğazları, şirketlerin karşılaştığı en büyük teknik engeller arasında yer alıyor. Örneğin GLM-5.3 gibi gelişmiş modellerin FP8 formatındaki ağırlıkları tek bir ml.p5.48xlarge örneğinin sunduğu 640 gigabaytlık GPU belleğini, anahtar-değer önbelleği ve çalışma zamanı ek yükleri Hesaba katılmadan bile aşabiliyor. Bu yeni entegrasyon, çoklu düğüm dağıtımı ve ayrıştırılmış ön işlem ile çözümleme yeteneklerini bir araya getirerek bu donanım sınırlarını aşmayı hedefliyor.
NVIDIA Dynamo ve HyperPod Entegrasyonunun Çalışma Mekaniği
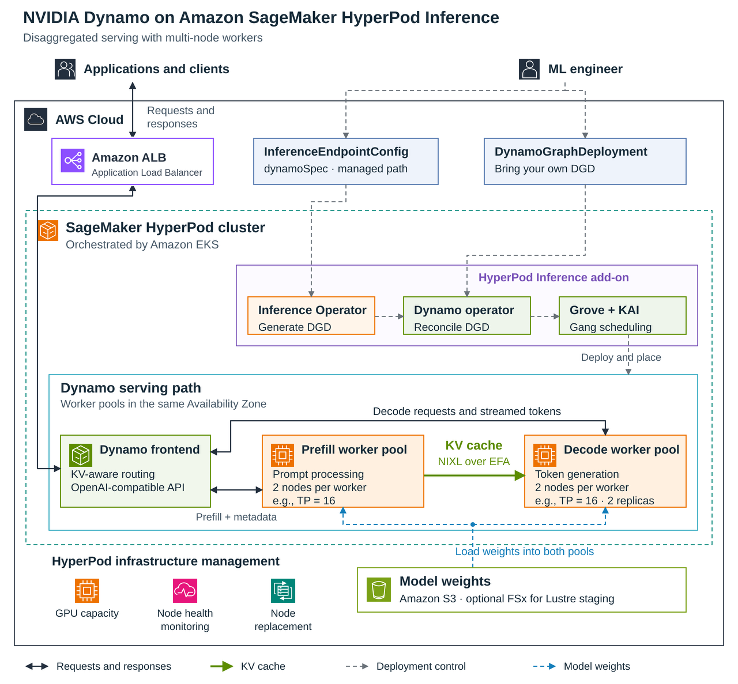
NVIDIA Dynamo, çoklu düğüm dağıtımlarını, ayrıştırılmış ön yükleme ve çözümleme süreçlerini ve anahtar-değer önbelleği farkındalığına sahip yönlendirme mekanizmalarını vLLM, SGLang ve TensorRT-LLM gibi popüler altyapı motorlarıyla birlikte destekleyen açık kaynaklı dağıtık bir çıkarım çatısı olarak öne çıkıyor. Amazon SageMaker HyperPod altyapısı ise yüksek performanslı Elastic Fabric Adapter ağ mimarisi, koordine edilmiş grafik işlemci zamanlaması, düğüm sağlığı izleme ve otomatik kurtarma özellikleri ile bu dağıtımlara zemin hazırlıyor. HyperPod Inference eklentisi, sistemin sorunsuz çalışması için Dynamo özel kaynak tanımlarını, HyperPod Inference Operator, Dynamo operatörü, Grove pod grup yöneticisi ve Kubernetes yapay zekâ zamanlayıcısı gibi kritik bileşenleri otomatik olarak sisteme kuruyor.
Geliştiriciler bu yapıyı kendi iş akışlarına uyarlamak için iki farklı dağıtım yolundan yararlanabiliyor. Kendi DynamoGraphDeployment manifestosunu getiren ekipler mevcut yapılandırmalarını ve altyapı dosyalarını doğrudan kullanabilirken, InferenceEndpointConfig ve dynamoSpec yapılandırmasını tercih edenler ise standart OpenAI uyumlu arayüzler üzerinden hızlıca yeni uç noktalar oluşturabiliyor. Operatör, bu süreçte model ağırlıklarının Amazon Simple Storage Service veya Amazon FSx üzerinden otomatik olarak yüklenmesini ve ölçeklendirme süreçlerinin Kubernetes olay tabanlı otomatik ölçeklendirme altyapısıyla yönetilmesini sağlıyor.
Performans Testleri ve Ayrıştırılmış Mimarinin Avantajları
Yapılan performans testleri, özellikle Qwen3-235B ve Qwen3.5-397B gibi devasa modellere sahip sistemlerde ayrıştırılmış ön yükleme ve çözümleme yaklaşımlarının sunduğu devasa verim artışını açıkça ortaya koyuyor. Qwen3-235B-A22B-FP8 modeliyle yapılan kıyaslamalarda, ayrıştırılmış sunum yaklaşımı en yüksek birleştirilmiş verimliliğe kıyasla 2.05 kat daha fazla performans üreterek saniyede grafik işlemci başına 207 çıkış jetonuna ulaştı. Benzer şekilde, çoklu düğüm dağıtımlarında düğüm sınırlarının performans üzerinde ciddi bir ceza oluşturmadığı, iki düğümlü yapılandırmaların tek düğüm verimliliğinin yüzde 99.1 oranını koruyabildiği gözlemlendi. Bu durum, devasa dil modellerini ölçeklerken donanım maliyetlerini optimize etmek isteyen ekipler için büyük bir esneklik sağlıyor.
Pratik Uygulama Sürecinde Dikkat Edilmesi Gerekenler
Bu entegrasyonun üretim ortamlarında verimli kullanılabilmesi için doğru tariflerin seçilmesi, düğüm iletişimlerinin Elastic Fabric Adapter ile doğrulanması ve gerçekçi trafik senaryolarıyla kıyaslama testlerinin yapılması büyük önem taşımaktadır. Dağıtık sistemlerin karmaşıklığı göz önüne alındığında, ekiplerin donanım boyutlandırması yaparken model ağırlıkları ve anahtar-değer bellek gereksinimlerini dikkatle hesaplaması gerekir. AWS ve NVIDIA ortaklığıyla sunulan bu araçlar, şirketlerin altyapı yönetimine harcadığı zamanı azaltarak doğrudan yapay zekâ uygulamalarına odaklanmasına olanak tanırken, kurumsal yapay zekâ projelerinin ölçeklenebilirliğini bir üst seviyeye taşıyor.
Kaynaklar
- Managed NVIDIA Dynamo on Amazon SageMaker HyperPod Inference (aws.amazon.com)
- unite.ai
Bu yazı, yukarıdaki kaynaklardan yapay zekâ yardımıyla Türkçe olarak derlenmiş bir özettir. Ayrıntılar ve resmi bilgi için kaynaklara başvurun.